從原型到上線:Supabase 上線 Checklist 與系列總結 | Supabase 完整教學
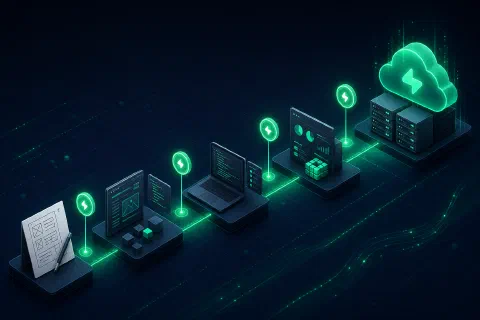
這是整個 Supabase 系列的第 50 篇,也是壓軸。前面 49 篇我們把 Supabase 的每一塊拆開來講——從 PostgreSQL 核心、RLS 授權、Auth、Realtime、Storage、Edge Functions,一路到部署維運與跨平台比較。這一篇不再教新語法,而是把所有知識串成一條可操作的路徑:如何把一個本機跑得起來的原型(Prototype),穩穩地推上生產環境(Production)。我們用一份上線 checklist 取代實作範例,帶你逐項確認 schema、RLS、Auth、migrations、測試、CI/CD、監控、備份都到位,最後替這趟 50 篇的旅程畫上句點。
前言
從原型到上線(Prototype to Production),指的是把一個「在你電腦上跑得起來、能 demo」的專案,變成一個「能承受真實使用者、真實流量、真實資料,而且不會半夜把你叫醒」的正式服務的完整過程。原型看重的是「能不能跑」;上線看重的是安全、可靠、可維護、可回溯。這兩者之間的距離,往往比新手想像的還要遠。
用一個類比:寫出原型,像是蓋好一間樣品屋——燈會亮、水會流、外觀漂亮,足以帶客戶參觀。但要真的讓人住進去,你還得檢查電線有沒有接地(安全)、水管會不會漏(資料完整)、承重牆夠不夠(效能)、有沒有煙霧偵測器與逃生路線(監控與備份)。上線 checklist,就是那份「驗屋清單」——每一項都是前人踩過坑、用事故換來的經驗。
Supabase 的特別之處在於:它讓你極快地蓋出樣品屋(這正是 BaaS 的魅力),但也因為太快,很多人會直接把樣品屋當成品屋交付——最典型的就是「建表建得飛快,卻忘了開 RLS」。這一篇的目的,就是幫你補上「從快速原型」到「安全上線」之間那段最容易被跳過的路。
本篇你會學到:
- 完整流程:從 schema 設計 → 一律開 RLS → Auth 設定 → 本機開發與 migrations → 測試 → 型別/CI-CD → 監控/備份 → 上線,每個階段該做什麼
- 一份可操作的 checklist:分成安全、資料、效能、維運四大類,逐項打勾就能上線
- 常見誤區:上線時最容易犯的錯,以及對應的正確做法
- 系列總結:回顧整個 50 篇 SB-1 到 SB-5 的學習路徑,以及最重要的——鼓勵你真的動手把它做出來
從原型到上線的流程
上線不是一個「按下部署鍵」的瞬間,而是一連串有先後順序的階段。以下把整條路徑拆成八個階段,每個階段都對應到這個系列前面某幾篇的知識。
階段一:Schema 設計
一切從資料模型開始。**Schema(資料庫結構)**是整個應用的地基,地基歪了,後面所有 RLS、API、查詢都會跟著歪。這個階段要想清楚:有哪些資料表、彼此的關聯(foreign key)、每個欄位的型別與約束(NOT NULL、UNIQUE、CHECK)、以及哪些欄位需要索引。
Supabase 底層是完整的 PostgreSQL,請善用它的關聯完整性——用 foreign key 而不是在應用層硬湊關聯,用 CHECK 約束把不合法的資料擋在資料庫門外。記住一個原則:能在資料庫層保證的正確性,就不要留給應用層,因為應用層會有 bug、會被繞過,而資料庫約束不會。
階段二:一律開啟 RLS
這是 Supabase 上線最關鍵、最不能省的一步,所以單獨拉出來當一個階段。
Supabase 的架構是:前端拿著可公開的 anon key,直接透過 PostgREST 自動產生的 REST API 存取資料庫。這意味著——只要一張 public schema 的表沒開 RLS,任何拿到 anon key 的人(也就是任何打開你網站原始碼的人)都能讀寫那張表的全部資料。
所以規則非常簡單粗暴:每一張 public 的表,建好後立刻啟用 RLS,並補上明確的 policy。
-- 建表後,第一件事:開 RLS
ALTER TABLE public.posts ENABLE ROW LEVEL SECURITY;

-- 再補上明確的 policy:使用者只能操作自己的資料
-- 注意用 (SELECT auth.uid()) 包起來,讓每次查詢只計算一次,效能更好
CREATE POLICY "users manage own posts"
  ON public.posts
  FOR ALL
  USING ((SELECT auth.uid()) = user_id)
  WITH CHECK ((SELECT auth.uid()) = user_id);
同時牢記兩把金鑰的分工:anon key 可公開、受 RLS 保護、放前端;service_role key 會完全繞過 RLS、絕對保密、只放後端(Edge Functions 或你的 server)。service_role key 若不小心進了前端或 git repo,等於把整個資料庫的鑰匙公開丟在路上。
階段三:Auth 設定
有了資料與授權,接著是身分。Supabase Auth(GoTrue) 幫你處理註冊、登入、OAuth、MFA,並和 RLS 深度整合(policy 裡的 auth.uid() 就來自這裡)。上線前這幾件事要設定好:
- SMTP:預設的內建寄信服務有嚴格的速率限制,只適合開發測試。正式上線一定要接自己的 SMTP(如 Resend、SendGrid、SES),否則驗證信、重設密碼信會寄不出去或被大量丟棄。
- JWT 過期時間:Access Token 建議設 1 小時(
JWT_EXPIRY=3600),並開啟 Refresh Token 輪替(REFRESH_TOKEN_ROTATION_ENABLED=true),把 Token 洩露的影響壓到最小。不要為了方便設成 24 小時甚至一年。 - 權限判斷來源:
user_metadata可以被使用者自己改,絕對不能用來判斷權限;要判斷角色請用app_metadata(只有 service_role 能改)或直接查資料庫裡的user_roles表。 - 重導網址白名單:設定好允許的 Redirect URLs,避免開放式重導漏洞。
階段四:本機開發與 Migrations
原型階段大家常直接在雲端 Dashboard 點按鈕改 schema,快是快,但改動不會留下可追溯、可重播的紀錄,團隊一多就會出現環境漂移(「我這有這欄位、你那沒有」)。
正確做法是用 Supabase CLI 在本機跑一份 Docker 版的 Supabase 開發,並且一切 schema 變更都走 migration 檔、納入版本控制:
# 產生一份新的 migration(會建立一個帶時間戳的 SQL 檔)
supabase migration new create_posts_table

# 在本機套用、驗證
supabase db reset

# commit 進 git,再推到遠端 / 由 CI 套用到 staging、production
supabase db push
這樣每一次 schema 變更都有紀錄、可 code review、可回溯,也能在 CI/CD 裡自動、可控地套用到不同環境。Migration 進版控,是專案從「一個人玩」邁向「一個團隊維護」的分水嶺。
階段五:測試
原型可以「手動點一點看起來對」,上線不行。至少要有:
- RLS 測試:這是最該優先寫的測試。用 anon key、以及不同使用者的身分,實際去打 API,驗證「A 使用者讀不到 B 使用者的資料」「沒登入讀不到受保護資料」。RLS 的 bug 不會噴錯,只會安靜地漏資料,所以必須主動測。
- 資料庫函式 / RPC 測試:用
pgTAP在資料庫層驗證你的函式與 policy 行為。 - 端對端測試:針對關鍵流程(註冊、登入、下單)跑 E2E,確保整條路徑串得起來。
階段六:型別與 CI/CD
型別安全能在編譯期就擋掉大量低級錯誤。Supabase CLI 可以從你的資料庫 schema 自動產生 TypeScript 型別:
# 從資料庫產生型別定義,前端 / 後端共用,schema 一改型別就跟著更新
supabase gen types typescript --linked > types/database.types.ts
把它接進 CI/CD 流程,一條龍自動化:push → 跑測試 → 套用 migrations 到 staging → 產生並比對型別 → 通過後才部署到 production。CI/CD 的意義在於——讓「正確的流程」變成預設,而不是靠人記得手動做。
階段七:監控與備份
上線之後,你需要「眼睛」和「保險」。
監控(眼睛):自架的話,用 Prometheus + Grafana 抓 Supabase 暴露的效能指標,設好關鍵告警——連線數逼近上限、平均查詢時間超過 1 秒、磁碟使用超過 80%、容器頻繁重啟、記憶體被 OOM Kill。雲端則善用 Dashboard 的 Reports 與用量警示。沒有監控,你只會在使用者尖叫時才知道出事。
備份(保險):雲端 Pro 方案有每日備份、更高方案有 PITR;自架則完全沒有內建備份,必須自己用 pg_dump(邏輯備份)或 WAL-G + S3(物理備份 + WAL 歸檔,可做到任意時間點 PITR)。而且——沒有測試過還原的備份,等於沒有備份。請把「每月一次完整還原演練」排進行事曆。
階段八:上線
前面七個階段都到位後,才是真正的上線:切換到 production 環境變數、把 anon/service_role/JWT secret 等所有預設密鑰換成正式且高強度的值、在 Kong / API Gateway 前方擺好處理 HTTPS 的反向代理(Kong 的 8000 port 絕不直接對外)、設定速率限制、確認 PostgreSQL 的 5432 port 不對外暴露。然後——小流量灰度、盯著監控、準備好回滾。
上線檢查清單
把上面的流程濃縮成一份可以逐項打勾的清單。上線前,一項一項確認。
安全類
- 每一張 public 表都啟用了 RLS,而且每張都有明確的 policy(不是開了 RLS 卻沒 policy,那會變成全部讀不到)
- 用 anon key 實際打過一次 API,驗證越權資料真的讀不到
-
service_rolekey 只在後端,不在任何前端程式碼、不在 git 歷史裡 - 所有預設密鑰全部更換(JWT secret、anon/service_role key、資料庫密碼、Vault 加密金鑰)
- JWT Access Token 過期設 1 小時 + 開啟 Refresh Token 輪替
- 權限判斷不依賴
user_metadata(改用app_metadata或查user_roles表) - Auth 重導網址設好白名單
- PostgreSQL 的 5432 port 不對外暴露;防火牆只開 80/443;遠端管理走 SSH Tunnel
- API Gateway 前方有反向代理處理 HTTPS,並設定速率限制(rate limit)
資料類
- Schema 用 foreign key、
NOT NULL、UNIQUE、CHECK約束把正確性守在資料庫層 - 所有 schema 變更都是 migration 檔並進了版本控制
- 已設定自動備份(雲端啟用/確認方案;自架自建 pg_dump 或 WAL-G)
- 做過至少一次完整還原演練,確認還原得回來、資料完整
- SMTP 已接正式服務(不再用內建測試寄信)
效能類
- RLS policy 用到的欄位(如
user_id)有建索引,避免百萬筆資料 Seq Scan - RLS policy 裡的
auth.uid()用(SELECT auth.uid())包起來,每次查詢只算一次 - Serverless / Edge / 高並發連線走 Supavisor 的 Transaction 模式(6543 port);長連線走 Session 模式(5432)
- 避免雙重池化(ORM 已透過 pooler 就停用自身連線池)
- 避免 N+1 查詢(用 SDK 的巢狀 SELECT 一次撈關聯資料)
- PostgreSQL 參數依伺服器規格調校(
shared_buffers、work_mem、log_min_duration_statement等)
維運類
- 監控與告警就位(連線數、慢查詢、磁碟、記憶體、容器重啟)
- CI/CD 流程能自動跑測試、套用 migrations、產生型別、再部署
- 有 RLS 測試 + 關鍵流程 E2E 測試
- 從 schema 產生的 TypeScript 型別已納入,前後端共用
- 環境分離(local / staging / production),各自獨立的專案與密鑰
- 準備好回滾方案與事故處理流程
常見誤區與最佳實踐
上線這一段,踩坑的地方高度集中。以下是最常見的幾個誤區,以及對應的正確做法。
誤區一:「建表建得飛快,RLS 之後再補。」 這是 Supabase 最致命的坑。「之後」通常等於「上線後才發現資料被爬光」。正確做法:把「建表 → 立刻開 RLS → 立刻寫 policy」當成一個不可分割的動作,並用 anon key 主動驗證越權讀不到。
誤區二:「service_role key 放前端比較方便,反正有 HTTPS。」 HTTPS 只加密傳輸,擋不住使用者打開瀏覽器 DevTools 直接看到 key。service_role 繞過所有 RLS,一旦外洩等於整個資料庫門戶大開。正確做法:service_role 永遠只在後端(Edge Functions / server),前端一律只用 anon。
誤區三:「直接在 Dashboard 改 schema 最快。」 快,但沒有紀錄、無法 review、無法在環境間同步,團隊很快就環境漂移。正確做法:一切走 migration 檔並進版控,透過 CLI / CI 套用。
誤區四:「有備份就安心了。」 沒還原測試過的備份是心理安慰。正確做法:定期(建議每月)做完整還原演練,記錄還原耗時與資料完整性。
誤區五:「RLS policy 直接寫 auth.uid() = user_id,而且不建索引。」 前者會讓每一行都重算一次 auth.uid(),後者會讓比對做全表掃描——資料一多就慢到不能用。正確做法:policy 寫成 (SELECT auth.uid()) = user_id,並且在 user_id 上 CREATE INDEX。
誤區六:「用內建寄信服務就上線。」 內建 SMTP 有嚴格速率限制、只為開發準備。正確做法:上線前接自己的 SMTP,確保驗證信、密碼重設信送得出去。
貫穿這些誤區的最佳實踐,其實只有一句話:把安全與正確性放在資料庫層,把流程自動化,並且永遠假設「會出事」而預先準備好保險。
系列總結
走到這裡,整個 Supabase 系列 50 篇,正式收束。
上一篇《Supabase vs Cloudflare》,我們把 Supabase 這個「以中央 Postgres 為核心的後端資料層」和 Cloudflare 這個「以全球邊緣為核心的網路平台」放在一起比,得到一個關鍵洞察:它們常常不是二選一,而是互補——Cloudflare 主外(邊緣分佈與網路),Supabase 主內(資料與授權)。那是整個系列在「選型視野」上的最後一塊拼圖。
而這一篇,我們把視角從「怎麼選、怎麼比」拉回到「怎麼真的做出來、推上線」——用一份 checklist,把前面所有零散的知識點,串成一條從原型到生產的完整路徑。
回頭看整趟旅程,這 50 篇其實是沿著五條主線層層堆疊上來的:
- SB-1 資料庫核心:一切的地基。Postgres、schema 設計、SQL、索引、關聯——你所有的資料與正確性都長在這裡。
- SB-2 存取層:資料怎麼被安全地存取。RLS 與 policy、自動產生的 PostgREST API、客戶端 SDK——這是 Supabase「資安在資料庫層」哲學最精華的一段。
- SB-3 核心服務:圍繞資料庫的後端能力。Auth(身分)、Realtime(即時)、Storage(儲存)——讓你不必自建後端就有完整功能。
- SB-4 運算與 AI:讓後端會「動」也會「想」。Edge Functions、資料庫函式、以及 pgvector 帶來的向量搜尋與 AI/RAG 能力。
- SB-5 工具維運 + 實戰/比較:讓它真正跑得久。CLI、migrations、監控、pg_cron、備份、自架、最佳實踐,加上實戰整合與跨平台比較(Firebase、Cloudflare),最後收束在這篇「從原型到上線」。
從第一篇的環境設定,到 schema、RLS、Auth、Realtime、Storage、Edge Functions,再到部署維運與選型比較,你現在手上握有的,已經不是零散的「怎麼用某個功能」,而是一整套**「如何用 Supabase 從零打造並穩定運營一個真實產品」**的能力。
但最後,我想留給你的不是總結,而是一個提醒:技術文章讀再多,不動手就永遠只是別人的知識。
真正把這 50 篇變成你的,只有一條路——開一個新專案,親手把它做到上線。從 supabase init 開始,設計你的第一張表、為它開上 RLS、接上 Auth、寫一條 migration、產生型別、部署、然後盯著你的第一個監控儀表板。你會踩到這篇 checklist 裡提到的每一個坑,而每踩一個、爬起來一次,這些知識就真正刻進你的手裡了。
這個系列到此結束,但你的 Supabase 之旅,才正要從「讀」變成「做」。動手吧。