用 Supabase 打造 RAG:pgvector + Edge Functions 端到端 | Supabase 完整教學
上一篇《embeddings 與相似度搜尋》我們把「產 embedding → 存 pgvector → 用
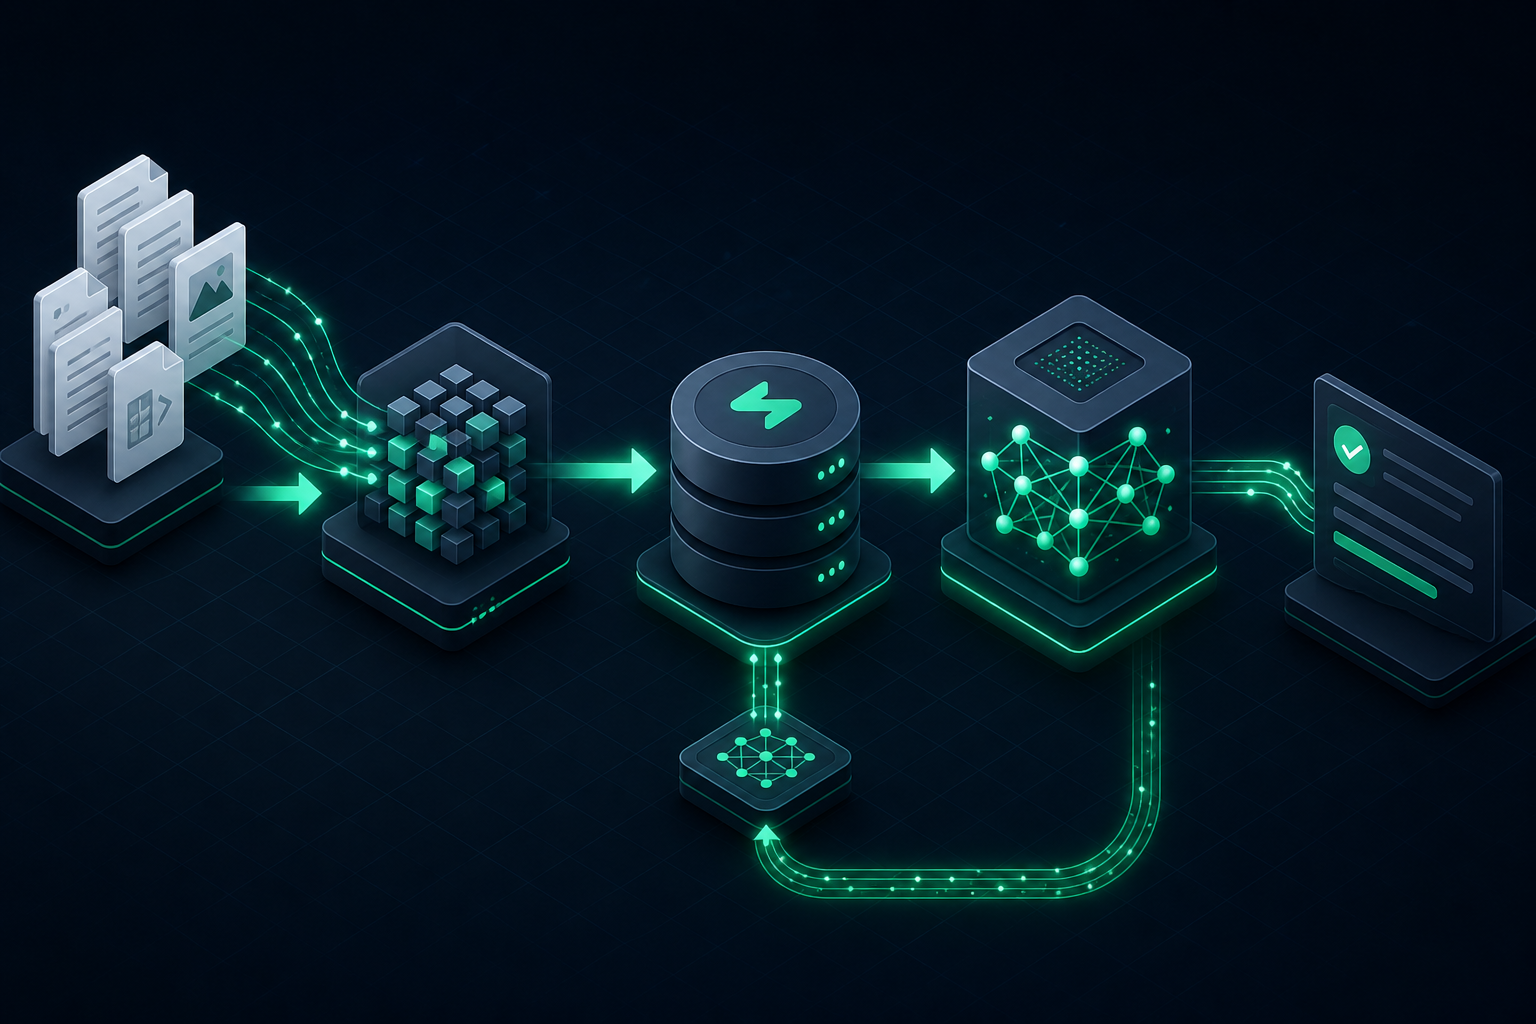
match_documents檢索」這條語意搜尋的迴路跑通了。但搜尋只是把相關文件「找出來」——真正的 RAG(檢索增強生成)還要再往前一步:把找到的內容交給 LLM,讓它「讀懂並回答」。這一篇,我們把整條端到端管線接起來:文件分塊 → 用 Edge Functions 產 embeddings 存進 pgvector → 查詢時用match_documents檢索 top-k → 組出帶來源的 prompt → 呼叫 LLM 串流生成回答。一個真正「基於你自己知識庫」回答問題的應用,這篇會動起來。
前言
一句話定義本篇要做的事:RAG(Retrieval-Augmented Generation,檢索增強生成)就是「先用向量搜尋從知識庫撈出跟問題最相關的幾段文字,再把這幾段塞進 prompt 交給 LLM,讓它基於這些真實資料生成回答」。 它讓大型語言模型不再只靠訓練時的舊知識瞎猜,而是「開卷考試」——先翻你的資料,再作答。
先接住上一篇《embeddings 與相似度搜尋》的脈絡。那一篇我們學會了 match_documents:把使用者問題轉成 query embedding,用 1 - (embedding <=> query_embedding) 算餘弦相似度,撈出最相似的前幾筆。但那條線到「撈出相關文件」就停了。 本篇要把它接上 LLM——檢索只是 RAG 的前半場(Retrieval),後半場是把檢索結果「增強」進 prompt(Augmented)再「生成」答案(Generation)。這三個字,正好就是 RAG 的全名。
用一個類比理解整條流程。想像你請了一位很聰明、但沒讀過你公司內部文件的顧問:直接問他「我們公司的退貨政策是什麼?」,他只會憑常識亂猜(這就是沒有 RAG 的裸 LLM,容易「幻覺」)。RAG 的做法是——在問他之前,先從檔案櫃裡抽出「最相關的那幾頁」(向量檢索)攤在他面前,跟他說「只根據這幾頁回答,沒寫的就說不知道」(組 prompt),他才給出準確、可溯源的答案(LLM 生成)。檔案櫃就是 pgvector,抽檔案的動作就是 match_documents,那句叮嚀就是你組 prompt 的方式。
本篇你會學到:
- 文件分塊(Chunking):為什麼要切、怎麼切、chunk 大小與重疊怎麼抓
- 用 Edge Functions 產 embeddings 存進 pgvector:把「攝取」整段搬到伺服器端,API key 不外洩(整合第 031–034 篇)
- 檢索 top-k:用
match_documents同時靠match_count與match_threshold雙重把關 - 組 prompt + LLM 串流生成:把檢索結果連編號一起放進 prompt,再串流回答(呼應第 034 篇的串流)
本篇聚焦「完整 RAG 管線」的組裝,不重述 embedding 產生與相似度搜尋的細節(那是上一篇的主題)。向量索引(HNSW/IVFFlat)與自動 embeddings 管線,留給下一篇。以下模型名稱、維度、API 介面與函式行為請以官方文件為準。
核心概念
RAG 聽起來玄,但拆開來只有兩個階段、六個步驟。把這張心智圖建立起來,後面寫程式就只是「照著圖填空」。
一、RAG 的兩階段:索引(一次性)與查詢(每次請求)
RAG 最容易混淆的地方,是把「準備知識庫」和「回答問題」混為一談。務必把它們拆成兩個獨立的階段:
【階段一:索引 / 攝取(Indexing,一次性,或文件更新時才做)】
原始文件
   │  ① 分塊 Chunking(切成 400~600 tokens 的小段)
   ▼
一堆 chunks(純文字段落)
   │  ② 用「同一個」embedding 模型逐段產生向量
   ▼
chunks + embeddings
   │  ③ 存進 pgvector(document_chunks 表)
   ▼
可被搜尋的知識庫

【階段二:查詢 / 生成(Querying,每次使用者提問都跑一遍)】
使用者問題
   │  ④ 用「同一個」模型把問題轉成 query embedding
   ▼
query embedding
   │  ⑤ 檢索 Retrieval:match_documents 撈 top-k(+ threshold 過濾)
   ▼
最相關的幾個 chunks
   │  ⑥ 增強 Augment:把 chunks 連編號組進 prompt
   ▼
帶 context 的 prompt
   │  ⑦ 生成 Generation:交給 LLM,串流輸出回答
   ▼
基於你知識庫的答案
看懂這張圖,就抓到 RAG 的三個關鍵:一、索引階段做一次就好(除非文件變了),查詢階段每次都跑;二、索引和查詢必須用「同一個 embedding 模型」,座標系才對得上(上一篇的鐵律);三、真正的「檢索」發生在資料庫(match_documents),真正的「生成」發生在 LLM,中間靠 prompt 把兩者黏起來。
二、為什麼要分塊(Chunking)?
你可能會問:為什麼不直接把整篇文件產一個 embedding 就好?兩個原因。
第一,embedding 是「壓縮」:一個向量把整段文字的語意壓成幾百個數字。文字越長,壓縮損失越大——一整篇萬字長文擠成一個 1536 維向量,細節全糊掉了,搜「某個具體段落」根本搜不準。切成小塊,每塊語意單純,向量才能精準代表它。
第二,檢索的粒度就是餵給 LLM 的粒度:你檢索出的 chunk 會原封不動塞進 prompt。chunk 太大,塞進去浪費 token 又混入無關內容;chunk 太小,又缺乏上下文讓 LLM 讀不懂。所以 chunk 大小是 RAG 品質的第一個旋鈕:
| 應用場景 | 建議 chunk 大小 | 重疊(overlap) |
|---|---|---|
| 一般文件問答 | 400–600 tokens | 50 tokens |
| 程式碼搜尋 | 依函式/類別切分 | 10–20 tokens |
| 法律/財務文件 | 200–400 tokens | 30 tokens |
| 長文章摘要 | 800–1000 tokens | 100 tokens |
重疊(overlap) 是讓相鄰 chunk 共享一小段內容,避免把一個完整句子或概念硬切成兩半、導致兩邊都搜不到。這是切分時的小巧思。
三、關鍵術語速查
| 術語 | 白話解釋 |
|---|---|
| Chunk(分塊) | 把長文件切成的一小段文字,是檢索與餵給 LLM 的最小單位 |
| Retrieval(檢索) | 用 match_documents 從 pgvector 撈出最相關的 chunks |
| top-k | 檢索回傳的筆數,對應 match_count(通常 3~8 筆) |
| match_threshold | 相似度門檻,低於此值的 chunk 直接淘汰(過濾雜訊) |
| Augment(增強) | 把檢索到的 chunks 組進 prompt 當作「參考資料」 |
| Generation(生成) | 把帶 context 的 prompt 交給 LLM 產生最終回答 |
| Grounding(接地) | 用檢索資料「綁住」LLM,讓它別憑空捏造,是 RAG 的核心目的 |
實作範例
下面走一遍完整端到端管線:建三層表 → 寫 match_documents → 分塊 → 用 Edge Function 攝取(產 embedding 存 pgvector)→ 用 Edge Function 查詢(檢索 + 組 prompt + LLM 串流)。以 OpenAI text-embedding-3-small(1536 維)產 embedding、以一個 chat 模型生成回答為例(模型名稱請以官方為準,可自由替換)。
一、建立知識庫資料表
延續上一篇,但這裡用更貼近生產環境的「文件 / 分塊」兩層結構:documents 存文件層 metadata,document_chunks 存每個 chunk 的文字與向量。
-- 啟用 pgvector(上一篇已介紹,這裡確保存在)
create extension if not exists vector with schema extensions;

-- 文件主表(metadata 層)
create table documents (
  id bigint primary key generated always as identity,
  title text not null,
  source_url text,
  created_at timestamptz default now()
);

-- 分塊表(實際被檢索的單位:文字 + 向量)
create table document_chunks (
  id bigint primary key generated always as identity,
  document_id bigint references documents(id) on delete cascade,
  content text not null,
  chunk_index integer not null,
  embedding extensions.vector(1536),   -- 對應 text-embedding-3-small
  created_at timestamptz default now()
);
分成兩層的好處:一份文件被切成很多 chunk,document_chunks 用 document_id 指回 documents;日後刪除文件時 on delete cascade 會連帶清掉它的所有 chunk,不留孤兒資料。
二、寫 match_documents 檢索函式
這是檢索階段的主角,和上一篇同源——把相似度查詢封裝成 SQL 函式,因為 PostgREST 不支援直接使用向量運算子。這裡改成查 document_chunks 表,回傳 content 與 similarity:
-- 檢索:用餘弦相似度找出最接近 query 的 chunks
create or replace function match_documents(
  query_embedding extensions.vector(1536),   -- 查詢向量,維度須與欄位一致
  match_threshold float default 0.7,          -- 相似度門檻(過濾雜訊)
  match_count int default 5                   -- top-k,最多回傳幾筆
)
returns table (
  id bigint,
  content text,
  similarity float
)
language sql stable
as $$
  select
    dc.id,
    dc.content,
    -- 餘弦相似度 = 1 - 餘弦距離;越大越相似
    1 - (dc.embedding <=> query_embedding) as similarity
  from document_chunks dc
  -- 雙重把關之一:只保留相似度「高於」門檻的 chunk
  where 1 - (dc.embedding <=> query_embedding) > match_threshold
  -- 依距離由小到大排序(距離越小 = 越相似),之後才能被向量索引加速
  order by dc.embedding <=> query_embedding asc
  -- 雙重把關之二:只取前 match_count 筆
  limit match_count;
$$;
注意 where 的 match_threshold 與 limit 的 match_count——這就是 RAG 檢索的雙重把關:threshold 控品質(不夠像的淘汰)、top-k 控數量(最多幾筆)。兩者一起決定「哪些 chunk 會進到 prompt」。
三、文件分塊(Chunking)
攝取的第一步是把長文件切成 chunk。這裡示範一個帶重疊的固定長度切分(以空白切詞近似 token;正式專案建議改用能尊重段落與句界的切分器,避免把句子切爛):
// 帶重疊的段落感知切分:以 ~500 token 為上限、50 token 重疊
function chunkText(
  text: string,
  chunkSize = 500,
  chunkOverlap = 50,
): string[] {
  // 以空白粗略估算 token(正式環境建議用 tokenizer 精算)
  const words = text.split(/\s+/).filter(Boolean)
  const chunks: string[] = []

  for (let i = 0; i < words.length; i += chunkSize - chunkOverlap) {
    const chunk = words.slice(i, i + chunkSize).join(' ')
    if (chunk.trim()) chunks.push(chunk)   // 相鄰 chunk 會共享 50 個字(重疊)
  }
  return chunks
}
chunkSize - chunkOverlap 是每次前進的步長:切 500 字、但只前進 450 字,於是每個 chunk 的尾巴 50 字會出現在下一個 chunk 的開頭——這就是重疊,用來保住被切在邊界上的完整語意。
四、用 Edge Function 攝取:產 embedding 存進 pgvector
現在把「分塊 → 產 embedding → 存 pgvector」整段搬進 Edge Function(Deno 無伺服器環境,第 031–034 篇的主題)。這麼做的理由和上一篇一樣:OPENAI_API_KEY 與 service_role_key 絕不能出現在前端,只能留在伺服器端。前端只丟「標題 + 原始內文」,攝取工作全在 Edge Function 完成:
// supabase/functions/ingest/index.ts
import { serve } from 'https://deno.land/std@0.177.0/http/server.ts'
import { createClient } from 'https://esm.sh/@supabase/supabase-js@2'

serve(async (req: Request) => {
  const { title, content, sourceUrl } = await req.json()

  const supabase = createClient(
    Deno.env.get('SUPABASE_URL')!,
    Deno.env.get('SUPABASE_SERVICE_ROLE_KEY')!,   // 伺服器端才有的 service role key
  )

  // 1. 建立文件層記錄,拿到 document_id
  const { data: doc, error: docErr } = await supabase
    .from('documents')
    .insert({ title, source_url: sourceUrl })
    .select()
    .single()
  if (docErr) {
    return new Response(JSON.stringify({ error: docErr.message }), { status: 500 })
  }

  // 2. 分塊
  const chunks = chunkText(content, 500, 50)

  // 3. 批次產生 embeddings(一次呼叫送整批,省錢又快)
  const embedRes = await fetch('https://api.openai.com/v1/embeddings', {
    method: 'POST',
    headers: {
      'Authorization': `Bearer ${Deno.env.get('OPENAI_API_KEY')}`,
      'Content-Type': 'application/json',
    },
    body: JSON.stringify({
      model: 'text-embedding-3-small',   // 索引與查詢必須用「同一個」模型
      input: chunks,                     // 直接送整個 chunk 陣列
    }),
  })
  const { data: embeddings } = await embedRes.json()

  // 4. 把每個 chunk + 它的向量批次存進 pgvector
  const rows = chunks.map((chunk, i) => ({
    document_id: doc.id,
    content: chunk,
    chunk_index: i,
    embedding: embeddings[i].embedding,   // number[],長度 1536;SDK 會處理格式
  }))
  const { error: insErr } = await supabase.from('document_chunks').insert(rows)
  if (insErr) {
    return new Response(JSON.stringify({ error: insErr.message }), { status: 500 })
  }

  return new Response(
    JSON.stringify({ documentId: doc.id, chunks: chunks.length }),
    { headers: { 'Content-Type': 'application/json' } },
  )
})
這支函式把 RAG 索引階段的三步(分塊、產 embedding、存 pgvector)一次完成。實務上你會為每份文件呼叫它一次,就把整個知識庫灌好了。部署與設定 secret 的方式(supabase functions deploy ingest、supabase secrets set OPENAI_API_KEY=...)沿用第 031–034 篇的做法。
五、用 Edge Function 查詢:檢索 + 組 prompt + LLM 串流生成
這是整篇的高潮——查詢階段的完整 Edge Function,把「④ query embedding → ⑤ 檢索 → ⑥ 組 prompt → ⑦ LLM 串流生成」四步一氣呵成。前端只丟一句純文字問題:
// supabase/functions/rag/index.ts
import { serve } from 'https://deno.land/std@0.177.0/http/server.ts'
import { createClient } from 'https://esm.sh/@supabase/supabase-js@2'

serve(async (req: Request) => {
  const { question } = await req.json()   // 前端只傳純文字問題

  const openaiKey = Deno.env.get('OPENAI_API_KEY')!
  const supabase = createClient(
    Deno.env.get('SUPABASE_URL')!,
    Deno.env.get('SUPABASE_SERVICE_ROLE_KEY')!,
  )

  // ④ 把問題轉成 query embedding(務必用「同一個」模型)
  const embedRes = await fetch('https://api.openai.com/v1/embeddings', {
    method: 'POST',
    headers: { 'Authorization': `Bearer ${openaiKey}`, 'Content-Type': 'application/json' },
    body: JSON.stringify({ model: 'text-embedding-3-small', input: question }),
  })
  const { data: [{ embedding: queryEmbedding }] } = await embedRes.json()

  // ⑤ 檢索:呼叫 match_documents 撈 top-k(threshold + match_count 雙重把關)
  const { data: matches, error } = await supabase.rpc('match_documents', {
    query_embedding: queryEmbedding,
    match_threshold: 0.7,
    match_count: 5,
  })
  if (error) {
    return new Response(JSON.stringify({ error: error.message }), { status: 500 })
  }

  // 過濾後一筆都沒有 → 誠實回覆找不到,不讓 LLM 亂編
  if (!matches || matches.length === 0) {
    return new Response('抱歉,知識庫中找不到與您問題相關的資料。', {
      headers: { 'Content-Type': 'text/plain; charset=utf-8' },
    })
  }

  // ⑥ 增強:把每個 chunk「連編號」組進 context,方便模型標註來源
  const context = matches
    .map((m: { content: string }, i: number) => `[${i + 1}] ${m.content}`)
    .join('\n\n')

  const systemPrompt = `你是一個只根據「提供的知識庫內容」回答問題的助理。
規則:
1. 只能根據下方知識庫內容回答,不可自行編造。
2. 如果知識庫中沒有相關資訊,請直接說「知識庫中沒有相關資料」,不要猜測。
3. 回答時在句末用 [編號] 標註你引用了哪一段來源。

知識庫內容:
${context}`

  // ⑦ 生成:呼叫 LLM,並「串流」輸出(呼應第 034 篇的串流做法)
  const chatRes = await fetch('https://api.openai.com/v1/chat/completions', {
    method: 'POST',
    headers: { 'Authorization': `Bearer ${openaiKey}`, 'Content-Type': 'application/json' },
    body: JSON.stringify({
      model: 'gpt-4o-mini',   // chat 模型,名稱請以官方為準,可自由替換
      stream: true,           // 開啟串流
      temperature: 0.2,       // 降低溫度使回答更貼近資料、更穩定
      messages: [
        { role: 'system', content: systemPrompt },
        { role: 'user', content: question },
      ],
    }),
  })

  // 把 LLM 的 SSE 串流即時轉發給前端(逐字吐出,體感更快)
  const stream = new ReadableStream({
    async start(controller) {
      const reader = chatRes.body!.getReader()
      const decoder = new TextDecoder()
      const encoder = new TextEncoder()

      while (true) {
        const { done, value } = await reader.read()
        if (done) break
        // 解析 OpenAI 的 SSE 格式,抽出每個 token 的文字
        const lines = decoder.decode(value).split('\n').filter((l) => l.startsWith('data: '))
        for (const line of lines) {
          const payload = line.replace('data: ', '')
          if (payload === '[DONE]') continue
          try {
            const token = JSON.parse(payload).choices?.[0]?.delta?.content ?? ''
            if (token) controller.enqueue(encoder.encode(token))
          } catch { /* 忽略非 JSON 的心跳行 */ }
        }
      }
      controller.close()
    },
  })

  return new Response(stream, {
    headers: { 'Content-Type': 'text/plain; charset=utf-8' },
  })
})
逐步拆解這支函式的關鍵設計:
- ④ query embedding 用同一個模型:
text-embedding-3-small從頭到尾一致,這是上一篇的鐵律,模型不一致整個檢索就毀了。 - ⑤ 雙重把關:
match_threshold: 0.7過濾雜訊、match_count: 5限制筆數。緊接著的「一筆都沒有就回覆找不到」是 RAG 的安全網——寧可誠實說沒有,也不讓 LLM 硬掰。 - ⑥ chunk 連編號放進 prompt:
[1]、[2]… 讓 context 結構清晰,並在 system prompt 明確要求「只根據資料回答、標註來源、沒有就說沒有」——這三句話是把 LLM「綁」在你資料上(grounding)、防幻覺的關鍵。 - ⑦ 串流生成:
stream: true讓 LLM 逐 token 吐出,Edge Function 邊收邊轉發給前端,使用者不必等整段生成完才看到字,體感快得多(串流細節呼應第 034 篇)。
六、前端呼叫:只傳問題、即時顯示串流
前端完全碰不到任何 API key,只丟問題、逐段讀取串流回應顯示:
// 前端呼叫 RAG Edge Function(不含任何 secret)
const res = await fetch('https://<project>.supabase.co/functions/v1/rag', {
  method: 'POST',
  headers: {
    'Authorization': `Bearer ${SUPABASE_ANON_KEY}`,   // 只帶 anon key
    'Content-Type': 'application/json',
  },
  body: JSON.stringify({ question: '你們的退貨政策是幾天內?' }),
})

// 逐段讀取串流,即時把答案渲染到畫面上
const reader = res.body!.getReader()
const decoder = new TextDecoder()
let answer = ''
while (true) {
  const { done, value } = await reader.read()
  if (done) break
  answer += decoder.decode(value)
  render(answer)   // 每收到一段就更新 UI,打字機效果
}
到這裡,一條完整的 RAG 管線就跑通了:文件進 ingest 被切塊、embed、存進 pgvector;使用者的問題進 rag,被檢索、組 prompt、交給 LLM 串流出「基於你知識庫」的答案。
常見錯誤與最佳實踐
坑一:chunk 切太大或太小。 切太大(例如整篇文件一個 chunk):向量把太多語意糊在一起,檢索不精準,還把一堆無關內容塞進 prompt 浪費 token。切太小(例如一句一個 chunk):每塊缺乏上下文,LLM 讀到殘缺片段反而答不好。正確做法:一般文件問答從 400–600 tokens、50 tokens 重疊起步;並「尊重段落」切分,別把完整句子硬切兩半。重疊就是為了保住被切在邊界的語意。
坑二:索引和查詢用了「不同的 embedding 模型」。
這是上一篇就強調的鐵律,在 RAG 裡一樣致命——若攝取(ingest)用 text-embedding-3-small、查詢(rag)卻用別的模型,兩邊向量座標系不同,檢索結果會是一堆牛頭不對馬嘴的雜訊,而且程式常常不會報錯。正確做法:把 embedding 模型名稱定成單一常數,攝取與查詢都引用它;哪天要換模型,整張 document_chunks 的向量得全部重新產生一次,不能新舊混用。
坑三:組 prompt 時沒把檢索到的來源放進去。
只在 system prompt 寫「請回答問題」卻忘了把 context(檢索到的 chunks)塞進去——LLM 根本沒看到你的知識庫,只能用訓練時的舊知識瞎掰,RAG 完全白做。正確做法:務必把檢索結果連編號組進 prompt,並加上「只根據以下資料回答、沒有就說不知道、標註來源編號」這類指令,把模型牢牢綁在你的資料上(grounding),既防幻覺又可溯源。
坑四:不設 match_threshold,把 top-k 全塞給 LLM。
match_count 只保證回傳「最相似的 k 筆」,但當知識庫裡根本沒有答案時,向量搜尋仍會忠實回傳相似度可能只有 0.4 的雜訊。全塞進 prompt,LLM 就被誤導硬擠出一個錯誤答案。正確做法:一定要設 match_threshold(例如 0.7)過濾低相似度;並在「過濾後一筆都不剩」時直接回覆「找不到相關資料」,別讓 LLM 亂編。threshold 控品質、top-k 控數量,缺一不可。
坑五:把 API key 放進前端,或攝取邏輯散落在客戶端。
在瀏覽器直接呼叫 OpenAI 產 embedding 或叫 LLM,等於把金鑰公開給全世界。正確做法:攝取(ingest)與查詢(rag)兩段都放進 Edge Function(第 031–034 篇),前端只傳純文字、只帶 anon key,OPENAI_API_KEY 與 service_role_key 留在伺服器端(用 supabase secrets set 設定)。
最佳實踐總結:
- chunk 從 400–600 tokens、50 重疊起步:尊重段落切分,別切爛句子
- embedding 模型單一來源:索引與查詢共用一個常數,換模型就整表重 embed
- prompt 一定要放 context + 來源編號:加上「只根據資料回答、沒有就說沒有」的指令
- 檢索雙重把關:
match_threshold控品質 +match_count控數量;空結果誠實回覆找不到 - 串流回應:
stream: true讓答案逐字吐出,使用者體感更快(呼應第 034 篇) - API key 留伺服器:攝取與查詢都在 Edge Function 完成,前端只傳文字
- 細節以官方為準:模型名稱、維度、API 介面都可能調整,正式決策前查官方文件
小結
這是 Supabase 系列教學的第 037 篇,AI/向量段的第三棒。上一篇《embeddings 與相似度搜尋》我們把「產 embedding → 存 pgvector → 用 match_documents 檢索」的語意搜尋迴路跑通了——但它到「找出相關文件」就停了。這一篇,我們把這條迴路接上大型語言模型,組出一條真正的端到端 RAG 管線:文件分塊 → 用 Edge Functions 產 embeddings 存 pgvector → match_documents 檢索 top-k → 組帶來源的 prompt → LLM 串流生成回答。相似度搜尋,正是 RAG 的心臟。
核心觀念濃縮成一句話:RAG 就是「索引階段把文件切塊、embed、存進 pgvector;查詢階段用同一個模型把問題轉成向量、用 match_documents 靠 threshold 與 top-k 雙重把關撈出最相關的幾段、連編號組進 prompt 並叮嚀 LLM 只根據資料回答,最後串流生成答案」;攝取與查詢都放 Edge Function,API key 不外洩。
- 兩階段:索引(分塊 → embed → 存)做一次;查詢(embed → 檢索 → 組 prompt → 生成)每次跑
- Edge Functions 整合:
ingest負責攝取、rag負責查詢,皆在伺服器端(第 031–034 篇) - 檢索雙重把關:
match_documents用match_threshold過濾雜訊 +match_count取 top-k - prompt grounding:chunk 連編號放進 context,指示 LLM 只依資料回答、標註來源、沒有就說沒有
- 串流生成:
stream: true逐 token 轉發給前端,體感更快
我們的 RAG 已經能動了,但知識庫一大就會冒出新問題:沒有向量索引時,match_documents 每次查詢都得掃描全表算距離,資料一多就慢如龜爬;而且文件更新後 embedding 得手動重產,很容易漏掉、造成資料漂移。下一篇《向量索引與自動 embeddings》,我們就來解決這兩件事——用 HNSW/IVFFlat 索引把檢索加速,再用觸發器搭配 pg_cron、pg_net 打造「文件一更新、embedding 自動同步」的管線,讓 RAG 從「能動」升級到「又快又不漂移」。