Embedded Resources 關聯查詢 | Supabase 完整教學
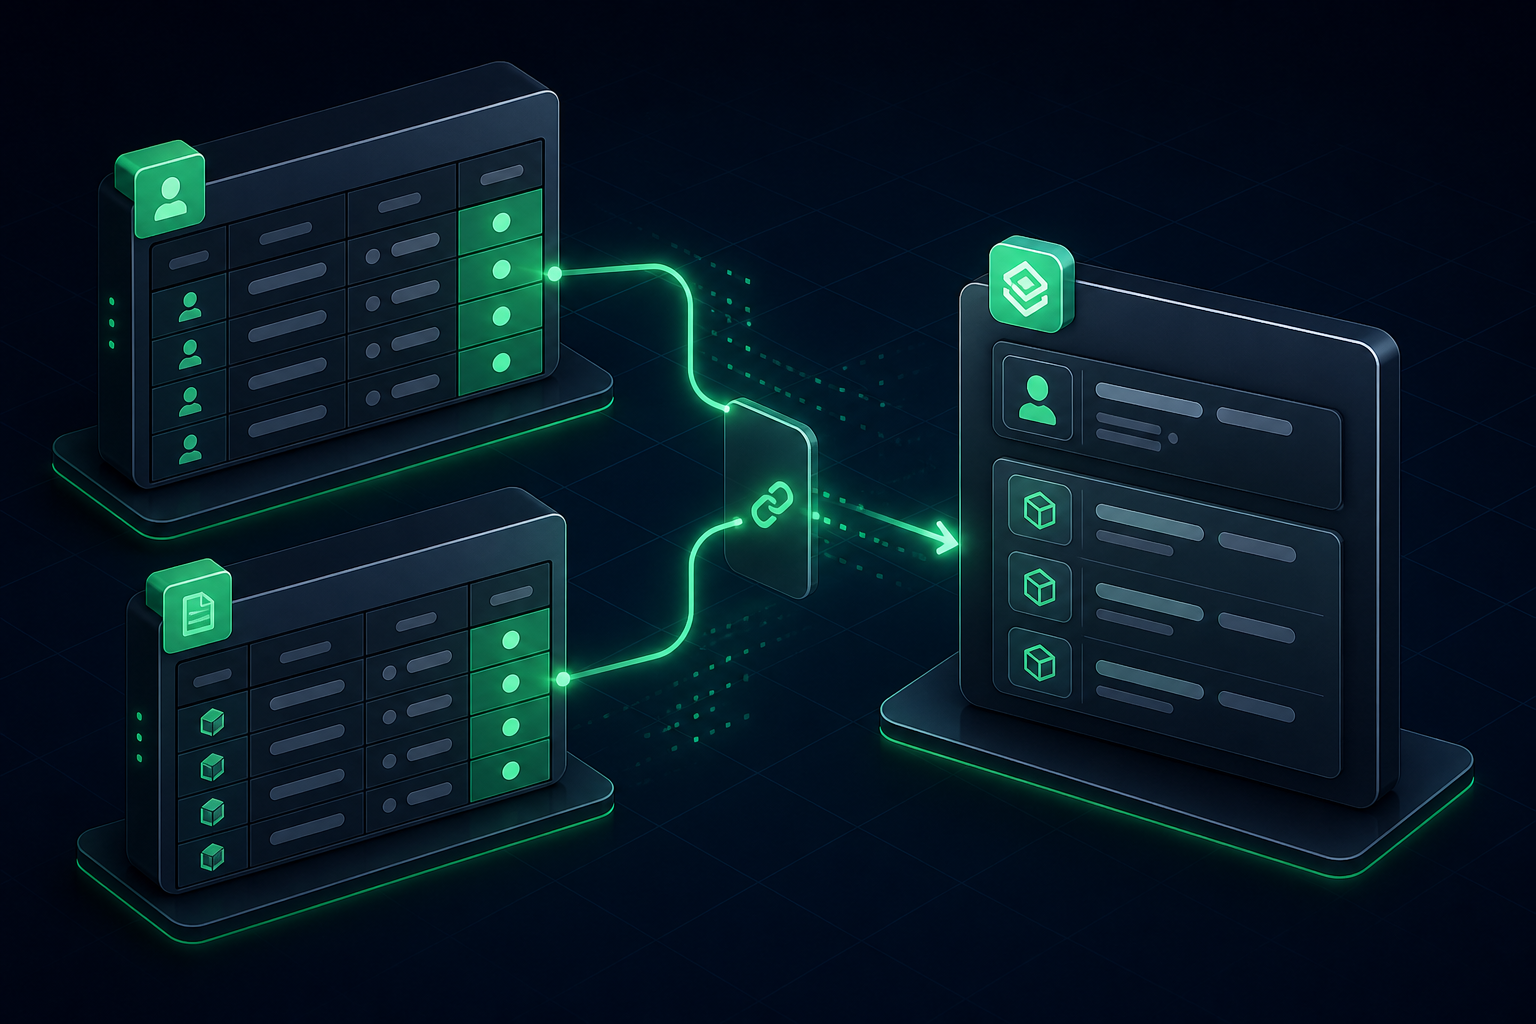
學會了《查詢、篩選與分頁》之後,你已經能對單一資料表查得又準又快。但真實世界的資料很少是孤立的——文章有作者、訂單有客戶、商品有分類、演員演過很多電影。這些關聯該怎麼在一次查詢裡一起撈出來,而不用發好幾支 API、再自己在前端拼?這一篇帶你把 Supabase(PostgREST)的 Embedded Resources 關聯查詢用到位:靠外鍵(Foreign Key)自動偵測表間關係,用
select('*, author(*)')這種寫法一次把關聯 join 成巢狀 JSON,並學會!inner內連接、巢狀篩選、多對多、以及多個外鍵指向同表時的關聯消歧義,徹底告別 N+1 查詢。
前言
一句話定義本篇主題:Embedded Resources(嵌入式資源,又稱關聯查詢)是 PostgREST 讓你「在一支查詢裡,順著外鍵把關聯資料表的內容一起展開成巢狀 JSON」的能力——你不用寫 SQL 的 JOIN,只要在 .select() 字串裡把關聯的表名寫進去,PostgREST 就會讀取 PostgreSQL 已定義的外鍵、自動偵測表與表之間的關係,把整棵資料樹一次撈回來,底層解析為單一 SQL JOIN。
上一篇《查詢、篩選與分頁》我們把單一表的讀取查詢用到位——選欄位、篩選、排序、分頁、計數。但那些查詢都停留在「一張表」的世界。真實的資料模型幾乎都是關聯的:一篇 posts 有一位 author(多對一)、一位 author 寫過很多 posts(一對多)、一部 film 有很多 actors、一位 actor 也演過很多 films(多對多)。傳統做法是先查文章、再拿每篇的 author_id 去查作者——這就是惡名昭彰的 N+1 查詢(撈 N 篇文章要多發 N 支查作者的 API)。Embedded Resources 讓你一支查詢解決。
用一個類比:Embedded Resources 就像「連鎖超市的組合包」。你去買一盒「壽司拼盤」,不必分別跑到生鮮區拿魚、雜糧區拿米、調味區拿醬油再自己組——超市(PostgREST)早就順著配方(外鍵)把相關的東西打包成一盒端給你。你的工作只是在購物清單(.select() 字串)上寫「我要壽司拼盤,順便把裡面的醬油也附上」,剩下的組合它幫你搞定。而這個「配方」的來源,就是資料庫裡的外鍵約束——沒有外鍵,就沒有配方,超市也就不知道該幫你打包什麼。
本篇你會學到:
- 外鍵自動 join:為什麼 embed 前一定要先有外鍵,以及
select('*, author(*)')的語法怎麼運作 - 兩個方向:多對一(回傳巢狀物件)與一對多(回傳巢狀陣列),以及指定關聯欄位與別名
!inner與巢狀篩選:LEFT vs INNER 的關鍵差異、如何對關聯表的欄位下條件- 多對多與關聯消歧義:透過 join table 自動偵測多對多、多個外鍵指向同表時如何用
!fk_name指定 - embedded 的 count:如何在關聯資源上取「有幾筆子資料」
核心概念
Embedded Resources 的一切都建立在一個基礎上:外鍵(Foreign Key)。先把這條因果鏈刻進腦中:
你建立外鍵約束(FK)
        │
        ▼
PostgREST 讀 PostgreSQL 系統目錄,偵測到表間關係
        │
        ▼
你在 .select() 寫進關聯表名 → PostgREST 自動 JOIN
        │
        ▼
關聯資料以巢狀 JSON(物件或陣列)回傳
沒有外鍵,就沒有 embed。 這是本篇最重要的一句話。如果你只是在 posts 表放了一個 author_id 整數欄位、卻沒有加上 REFERENCES profiles(id) 的外鍵約束,PostgREST 完全不知道這兩張表有關係,select('*, author(*)') 就會報 PGRST200(找不到關聯)。
外鍵定義關係方向
外鍵的方向決定了 embed 的結果形態。假設 posts.author_id 是外鍵、指向 profiles.id:
| 從哪張表查 | 關係類型 | 結果形態 | 為什麼 |
|---|---|---|---|
從 posts embed profiles | 多對一(Many-to-one) | 巢狀物件 | 一篇文章只有一位作者 |
從 profiles embed posts | 一對多(One-to-many) | 巢狀陣列 | 一位作者有很多文章 |
同一條外鍵,從兩個方向查會得到不同形態的結果——「多」的那一端回傳陣列,「一」的那一端回傳物件。這是理解關聯查詢結果的第一把鑰匙。
embed 語法示意
Embedded Resources 的語法就是把「關聯表名」寫進 .select() 字串裡,並用括號指定要從關聯表取哪些欄位:
// 語法骨架:主表欄位, 關聯表名( 關聯表要的欄位 )
.select('id, title, author( id, name )')
//        └─ posts 的欄位 ─┘  └─ 關聯表 ─┘└─ profiles 的欄位 ─┘
author(...) 這個括號結構就是在說「順著外鍵把關聯表 join 進來,並選它的這些欄位」。括號裡可以只寫 * 取全部欄位,也可以像主表一樣挑欄位、下別名、甚至再往下一層 embed(巢狀關聯)。
關鍵術語一次看懂
- Embedded Resource(嵌入式資源):被 embed 進來的那張關聯表(如上例的
author)。 - 關聯名稱(relationship name):
.select()括號前的那個名字。預設可用「關聯表名」或「外鍵欄位名」,也能用別名:表名改名。 !inner:把該關聯從預設的 LEFT JOIN 改成 INNER JOIN。!fk_name:明確指定走哪一條外鍵,用於消歧義。- 巢狀篩選(nested filter):對關聯表的欄位下條件,寫法是
.eq('關聯名.欄位', 值)。
實作範例
以下範例假設你有一組部落格資料表:profiles(作者)、posts(文章)、comments(留言)、tags(標籤)、以及多對多的中介表 post_tags。關鍵是它們之間都建好了外鍵。先看資料表與外鍵的定義(這一步是所有關聯查詢的前提):
-- 作者
create table profiles (
  id uuid primary key default gen_random_uuid(),
  name text not null
);

-- 文章:author_id 與 editor_id 兩條外鍵「都」指向 profiles(後面消歧義會用到)
create table posts (
  id bigint generated always as identity primary key,
  title text not null,
  is_published boolean default false,
  author_id uuid references profiles(id),   -- 外鍵 1:作者
  editor_id uuid references profiles(id)     -- 外鍵 2:編輯
);

-- 留言:post_id 外鍵指向 posts
create table comments (
  id bigint generated always as identity primary key,
  post_id bigint references posts(id),
  body text,
  is_spam boolean default false
);

-- 標籤與多對多中介表
create table tags (
  id bigint generated always as identity primary key,
  name text not null
);
create table post_tags (
  post_id bigint references posts(id),
  tag_id bigint references tags(id),
  primary key (post_id, tag_id)
);
先假設已建好 client:
import { createClient } from '@supabase/supabase-js'

const supabase = createClient(
  process.env.NEXT_PUBLIC_SUPABASE_URL,
  process.env.NEXT_PUBLIC_SUPABASE_ANON_KEY
)
範例一:多對一 embed(回傳巢狀物件)
查文章列表,順便把每篇文章的作者一起撈出來。因為「一篇文章對一位作者」,author 會是巢狀物件:
// 從 posts embed profiles:多對一 → author 是物件
const { data, error } = await supabase
  .from('posts')
  .select('id, title, author:profiles(id, name)')
//                    └ 別名 └ 關聯表 └ 取這兩欄

// data 例如:
// [
//   { id: 1, title: 'Hello', author: { id: 'uuid...', name: 'Ben' } },
//   { id: 2, title: 'World', author: { id: 'uuid...', name: 'Amy' } }
// ]
這裡有兩個重點。第一,author:profiles(...) 裡的 author: 是別名——若不寫別名,回傳的鍵名會是關聯表名 profiles;加了別名,回傳鍵就變成好懂的 author。第二,因為 posts 有兩條外鍵都指向 profiles(author_id 和 editor_id),這樣寫其實會觸發關聯不明確的錯誤——正確的消歧義寫法見範例五,這裡先示意語法骨架。
對照的 REST 請求——embed 就是在 select query 參數裡把關聯表名寫進去:
curl "$SUPABASE_URL/rest/v1/posts?select=id,title,author:profiles(id,name)" \
  -H "apikey: $ANON_KEY" \
  -H "Authorization: Bearer $ANON_KEY"
看出來了嗎?.select('id, title, author:profiles(id, name)') 就是 select=id,title,author:profiles(id,name)。supabase-js 只是幫你把這串 select 參數組好送出。
範例二:一對多 embed(回傳巢狀陣列)
反過來,從作者查、把他寫的所有文章一起撈。因為「一位作者對多篇文章」,posts 會是巢狀陣列:
// 從 profiles embed posts:一對多 → posts 是陣列
const { data } = await supabase
  .from('profiles')
  .select('id, name, posts(id, title)')

// data 例如:
// [
//   {
//     id: 'uuid...', name: 'Ben',
//     posts: [ { id: 1, title: 'Hello' }, { id: 5, title: 'Foo' } ]
//   }
// ]
同一組外鍵,只是查詢的起點反過來,結果就從物件變成陣列。這也是為什麼理解「外鍵方向」如此重要:你不是在選「要物件還是陣列」,而是由「從哪張表出發、往關係的哪一端走」自動決定。
範例三:!inner 內連接 + 巢狀篩選
這是關聯查詢最容易踩坑、也最關鍵的一段。先看巢狀篩選——對關聯表的欄位下條件,寫法是 關聯名.欄位:
// 查文章,並只保留「非垃圾」的留言
const { data } = await supabase
  .from('posts')
  .select('id, title, comments(id, body)')
  .eq('comments.is_spam', false)   // 巢狀篩選:條件下在關聯表的欄位上
這裡是最大的誤解來源:預設是 LEFT JOIN 語意。 上面這段查詢,篩選只作用在「哪些留言要放進巢狀陣列」——每一篇文章都還是會回傳,只是垃圾留言被濾掉;一篇完全沒有非垃圾留言的文章,會回傳成 comments: [](空陣列),而不是被整筆移除。
如果你要的是「只回傳那些真的有符合條件留言的文章」,必須把關聯改成 INNER JOIN——在關聯名稱後面加 !inner:
// !inner:沒有符合條件留言的文章,整筆被濾掉
const { data } = await supabase
  .from('posts')
  .select('id, title, comments!inner(id, body)')
  .eq('comments.is_spam', false)
一句話記住差別:預設(LEFT)=父層一定在、子陣列可能空;!inner=子資料沒符合的父層直接消失。 什麼時候用哪個?「顯示所有文章、順便帶上它的留言」用預設;「只想看有留言的文章」用 !inner。
REST 對照——!inner 與巢狀篩選都反映在 select 與 query 參數裡:
curl "$SUPABASE_URL/rest/v1/posts?select=id,title,comments!inner(id,body)&comments.is_spam=eq.false" \
  -H "apikey: $ANON_KEY" \
  -H "Authorization: Bearer $ANON_KEY"
範例四:多對多——透過 join table 自動偵測
posts 與 tags 是多對多關係(一篇文章有多個標籤、一個標籤屬於多篇文章),中間隔著中介表 post_tags。PostgREST 夠聰明,會自動偵測這個中介表,讓你可以直接 embed tags、彷彿它們直接相連:
// 直接 embed tags,PostgREST 自動穿過 post_tags 中介表
const { data } = await supabase
  .from('posts')
  .select('id, title, tags(id, name)')

// data 例如:
// [
//   { id: 1, title: 'Hello', tags: [ { id: 3, name: 'supabase' }, { id: 7, name: 'sql' } ] }
// ]
你完全不用手動寫 post_tags 這一層——只要中介表對兩邊都有外鍵,PostgREST 就會自動把多對多攤成一個巢狀陣列。當然,若你需要中介表本身的欄位(例如 post_tags 上記錄了「這個標籤是誰貼的」),也可以顯式地把中介表寫出來、再往下一層 embed:
// 顯式穿過中介表,取用中介表自己的欄位
const { data } = await supabase
  .from('posts')
  .select('id, title, post_tags(added_by, tags(name))')
範例五:關聯消歧義——多個外鍵指向同一張表
回到範例一埋的伏筆。posts 有兩條外鍵都指向 profiles:author_id(作者)和 editor_id(編輯)。這時你寫 select('*, profiles(*)'),PostgREST 無從得知你要 join 哪一條,會回傳**關聯不明確(ambiguous relationship)**的錯誤。
解法是用 ! 明確指定要走哪一條外鍵。你可以用外鍵約束名稱,也可以用外鍵欄位名:
// 用「外鍵約束名」消歧義,並各自下別名
const { data } = await supabase
  .from('posts')
  .select(`
    id, title,
    author:profiles!posts_author_id_fkey(name),
    editor:profiles!posts_editor_id_fkey(name)
  `)

// data 例如:
// [ { id: 1, title: 'Hello', author: { name: 'Ben' }, editor: { name: 'Amy' } } ]
拆解這個寫法:author: 是別名(決定回傳的 JSON 鍵名)、profiles 是關聯表、!posts_author_id_fkey 才是真正告訴 PostgREST 走哪條外鍵的關鍵。若你嫌約束名太長,也可以直接用外鍵欄位名:
// 用「外鍵欄位名」消歧義,同樣有效、更好記
const { data } = await supabase
  .from('posts')
  .select('id, title, author:profiles!author_id(name), editor:profiles!editor_id(name)')
REST 對照——消歧義的 !fk_name 一樣寫在 select 裡:
curl "$SUPABASE_URL/rest/v1/posts?select=id,title,author:profiles!author_id(name),editor:profiles!editor_id(name)" \
  -H "apikey: $ANON_KEY" \
  -H "Authorization: Bearer $ANON_KEY"
範例六:在 embedded 資源上做 count
有時你不需要每一筆子資料的內容,只想知道「有幾筆」——例如列文章時只想顯示「這篇有 12 則留言」,而不是把 12 則留言全撈回來。PostgREST 支援在 embedded 資源上用聚合計數:把關聯 embed 進來、只選一個 count 聚合:
// 只要留言則數,不要留言內容
const { data } = await supabase
  .from('posts')
  .select('id, title, comments(count)')

// data 例如:
// [ { id: 1, title: 'Hello', comments: [ { count: 12 } ] } ]
回傳的 comments 會是一個帶 count 的陣列([{ count: 12 }]),前端取 data[i].comments[0].count 即可。這比「把整個 comments 陣列撈回來再 .length」省下大量傳輸,尤其留言很多時差別巨大。
若同時想要頂層文章的總筆數(用於分頁)與每篇的留言數,可以並用上一篇學過的 { count } 選項:
const { data, count } = await supabase
  .from('posts')
  .select('id, title, comments(count)', { count: 'estimated' })
  .range(0, 19)
// count 是「總共幾篇文章」(分頁用);每筆的 comments[0].count 是「該篇幾則留言」
常見錯誤與最佳實踐
坑一:沒建外鍵就想 embed,報 PGRST200 找不到關聯。
Embedded Resources 完全建立在 PostgreSQL 的外鍵約束上——只放一個 author_id 欄位、沒有 REFERENCES 約束,PostgREST 就偵測不到關係。正確做法:補上外鍵,例如 ALTER TABLE posts ADD CONSTRAINT posts_author_id_fkey FOREIGN KEY (author_id) REFERENCES profiles(id)。加完後 schema cache 數秒內自動重載,關聯查詢隨即可用。切記:先有外鍵,才有 embed。
坑二:多個外鍵指向同表,卻沒消歧義。
posts 同時有 author_id 和 editor_id 指向 profiles,直接寫 profiles(*) 會報關聯不明確。正確做法:用 ! 指定外鍵——profiles!author_id(...) 或 profiles!posts_author_id_fkey(...),並搭配別名讓回傳鍵名清楚(author:profiles!author_id(...))。
坑三:以為巢狀篩選會濾掉父層,結果撈回一堆帶空陣列的父資料。
對 embedded 欄位下條件(.eq('comments.is_spam', false))預設是 LEFT JOIN:父層一定回傳、只濾子資料。正確做法:若要「只保留有符合條件子資料的父層」,關聯名加 !inner。分清「我要所有文章、順便帶留言」(預設)vs「我只要有留言的文章」(!inner)。
坑四:over-fetch——author(*) 或撈整個子陣列只為算數量。
embed 時習慣性寫 (*) 會把關聯表所有欄位都搬回來,浪費頻寬;只為顯示「幾則留言」卻把整個 comments 陣列撈回來更是浪費。正確做法:embed 也要只選需要的欄位(author(name) 而非 author(*));只要數量就用 comments(count) 聚合,別撈整個陣列再 .length。
坑五:對關聯表分頁/排序時忘了加關聯前綴。
想對 embedded 的 comments 排序,要寫 .order('created_at', { foreignTable: 'comments' })(或 .order('comments(created_at)')),不能直接 .order('created_at')(那是排頂層文章)。正確做法:所有針對關聯資源的篩選、排序、限制,欄位都要帶上關聯名前綴或指定 foreignTable。
坑六:用 embed 取代 RPC 硬做複雜聚合。
Embedded Resources 擅長「順著外鍵把樹狀關聯攤開」,但若你要的是跨多表的複雜計算、加總、分組報表,硬用 embed 會寫得又長又慢。正確做法:單純的關聯展開與計數用 embed;複雜聚合邏輯改用資料庫函式(下一篇的 RPC)封裝成一支 .rpc()。
最佳實踐總結:
- 先有外鍵,才有 embed:所有關聯查詢的前提,缺外鍵就補外鍵
- embed 也要選欄位:
author(name)勝過author(*),省頻寬 - 分清 LEFT 與
!inner:要不要濾掉「沒有符合子資料的父層」,決定加不加!inner - 多外鍵一定消歧義:用
!fk_name指定外鍵,搭配別名讓回傳鍵名好懂 - 只要數量就用
count聚合:comments(count)取代撈整個陣列再算長度 - 複雜聚合交給 RPC:embed 負責展開關聯,複雜計算留給資料庫函式
小結
這是 Supabase 系列教學的第 014 篇,延續第二大主題 SB-2「存取層」。上一篇《查詢、篩選與分頁》帶你把單一資料表的讀取查詢用到位——選欄位、篩選、排序、分頁、計數;這一篇則跨出單表,進入關聯查詢的世界,讓你用一支 API 就把整棵關聯資料樹撈回來。
核心觀念濃縮成一句話:Embedded Resources 靠 PostgreSQL 的外鍵自動偵測表間關係,讓你在 .select() 字串裡把關聯表名寫進去、就能把 join 後的資料以巢狀 JSON 一次取回——「多」端回傳陣列、「一」端回傳物件,!inner 決定要不要濾掉沒有符合子資料的父層,!fk_name 在多外鍵時消歧義,count 聚合讓你只取數量。
- 外鍵是前提:沒有外鍵約束就無法 embed,
PGRST200是最常見的入門錯誤 - 方向決定形態:多對一回傳巢狀物件、一對多回傳巢狀陣列,由查詢起點自動決定
!inner與巢狀篩選:預設 LEFT(父層必留、子資料可空),!inner才會濾掉無符合子資料的父層- 多對多與消歧義:中介表自動偵測多對多;多個外鍵指向同表用
!fk_name指定 - embed 也要省:只選需要欄位,只要數量就用
comments(count)
現在你已經能把彼此關聯的資料在一支查詢裡優雅地展開了。但有些需求,光靠自動 API 的宣告式查詢還是不夠——多步驟交易、複雜聚合、需要繞過或精細控制權限的業務邏輯,這些更適合封裝進資料庫函式。下一篇《RPC 呼叫資料庫函式》,我們就來看如何用 .rpc() 呼叫你在 PostgreSQL 裡寫好的 function,把複雜邏輯收進資料庫、用一支 API 觸發。下一篇見。