連線管理與 Pooler:Supavisor 實戰 | Supabase 完整教學
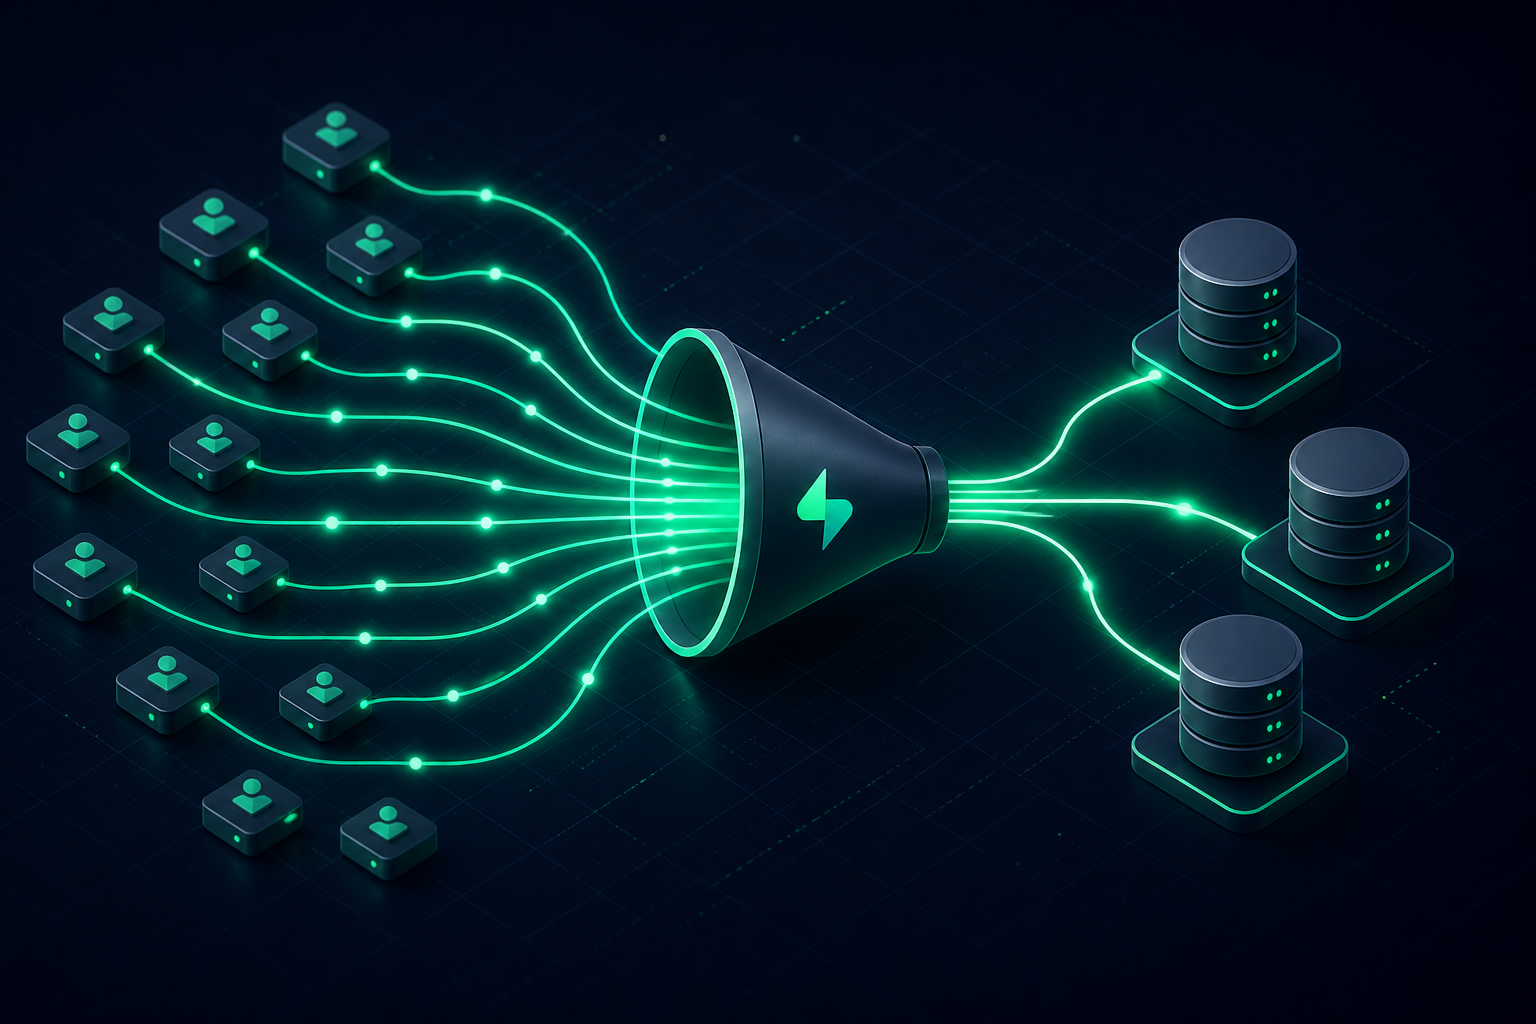
在 Supabase 的世界裡,寫好查詢只是第一步,能不能在高流量下「穩得住」,關鍵往往在連線管理。每一條 Postgres 連線都要吃掉伺服器記憶體,而 Serverless 環境動不動就想開一條新連線——這篇帶你搞懂 Supabase 自研的連線池器 Supavisor、
transaction mode與session mode的差異、direct 與 pooled 的埠與連線字串,以及為什麼 Serverless 一定要走 transaction pooler。
前言
一句話定義本篇主題:這篇要教你搞懂 Supabase 的連線管理——為什麼需要 connection pooler(連線池)、Supabase 自研的 Supavisor 如何運作、Direct Connection 與 pooled 連線的差別、transaction mode 與 session mode 各自的埠與適用場景,以及在 Serverless/Edge 情境為何非用 transaction pooler 不可。
上一篇《Database Functions 與 Triggers》我們讓資料庫「動了起來」——用函式封裝邏輯、用觸發器在資料變更瞬間自動反應。但當你的應用開始有真實流量,尤其是部署到 Vercel、Netlify、Supabase Edge Functions 這類 Serverless 平台時,一個新的瓶頸會浮現:連線數。你會發現查詢明明沒問題,網站卻突然回報「too many connections」而整個掛掉。這一篇就是要解決這個問題,也為整個「資料庫段」畫下句點。
用一個現實類比:Postgres 的連線就像一家餐廳的「桌位」,數量有限;連線池(Pooler)則像餐廳門口的「帶位服務生」。 如果沒有服務生,每位客人(請求)都自己衝進去佔一桌,就算只是進來喝杯水(跑一句短查詢)也要獨佔整桌,人一多桌位立刻被佔滿,後面的客人只能吃閉門羹。而帶位服務生(Pooler)的做法是:讓多位客人輪流共用少數幾桌——你點餐、上菜、結帳(一個交易)的期間才佔桌,一結束馬上讓出來給下一位。於是同樣的桌位數,能服務的客人翻了好幾倍。Supabase 的這位「服務生」就叫 Supavisor。
本篇你會學到:
- 為何需要連線池:Postgres 連線的成本、Serverless 為何特別容易耗盡連線
- Supavisor 是什麼:Supabase 自研的 Postgres 連線池器,如何在多客戶端間分配少數連線
- 兩種池化模式:
transaction modevssession mode的差異、各自的埠與適用場景 - 實務設定:Direct/Session/Transaction 三種連線字串怎麼寫、Serverless 該怎麼配、
prepared statements的坑怎麼繞
核心概念
為什麼需要連線池
先理解一件事:Postgres 的連線很「貴」。 每建立一條連線,Postgres 就會 fork 出一個獨立的後端行程,配置專屬記憶體。因此資料庫有一個連線數上限(依方案與機器規格而定,小方案可能只有幾十到上百條)。當同時開啟的連線超過上限,新的連線就會被拒絕,你會看到經典的 remaining connection slots are reserved 或 sorry, too many clients already 錯誤。
問題在傳統的長駐後端(一台 VM、一個常開的容器)不明顯——它啟動時建立一個固定大小的連線池(例如 10 條),之後所有請求共用這幾條,連線數穩定可控。但 Serverless/Edge 環境完全不同:
- 每個請求可能觸發一個全新的函式實例,各自初始化、各自開連線
- 流量尖峰時可能同時有數百個實例在跑,如果每個都開一條 Direct 連線,瞬間就爆掉連線上限
- 函式實例生命週期短、來去頻繁,連線建立/關閉的成本被放大
這就是連線池要解決的核心矛盾:用戶端想要「很多條連線」,但資料庫只能給「少數幾條」。 連線池坐在中間,對外假裝有海量連線可用,對內只維持少數實體連線,把用戶端的請求聰明地排到這幾條實體連線上輪流跑。
Supavisor:Supabase 的連線池器
Supavisor 是 Supabase 自行開發的雲原生 Postgres 連線池器(Connection Pooler),你可以把它想成「Postgres 連線的負載平衡器」。它接受來自成千上萬客戶端的連線,並在背後智慧地把這些請求分配到有限的實體 Postgres 連線上。傳統上這個角色由 PgBouncer 擔任,Supavisor 則是為多租戶、雲端規模設計的替代方案,行為上與 PgBouncer 相容(例如同樣支援 transaction 與 session 兩種池化模式)。
Supavisor 提供兩種池化模式,這是本篇最核心的觀念:
| 模式 | 連線何時借出/歸還 | 支援 prepared statements | 典型場景 |
|---|---|---|---|
| Session Mode(工作階段模式) | 整個 session(連線)期間都綁定同一條實體連線 | ✅ 支援 | 需要 IPv4 的長駐後端、需要 session 狀態或 prepared statements |
| Transaction Mode(交易模式) | 只在「一個交易進行中」借出,交易結束立刻歸還 | ❌ 不支援 | Serverless、Edge Functions、高並發 |
理解這兩種模式的差別,只要抓住「連線綁定的時間長短」:
- Session Mode 一綁就綁一整個連線期間。你連上來、做很多事、直到斷線,這條實體連線都是你的。因為狀態(包含 prepared statements、session 變數)全程保留,行為最接近直連,但每個客戶端都獨佔一條實體連線,池化的節省效果較有限。
- Transaction Mode 只綁一個交易。你開始一個交易(
BEGIN)到結束(COMMIT/ROLLBACK)之間才佔用一條實體連線,交易一結束連線馬上還回池裡給別人用。因此少數幾條實體連線就能服務大量並發客戶端,重用率最高——這正是 Serverless 需要的。代價是:交易之間你可能被分到不同的實體連線,任何「跨交易保留在連線上的狀態」都會失效,這就是它不支援 prepared statements 的根本原因。
Direct Connection vs Pooled
除了兩種池化模式,還有一個「完全不經過池化」的選項:Direct Connection(直接連線)。三者一起看:
| 連線方式 | 是否經過 Supavisor | 埠(以官方為準) | 適用場景 |
|---|---|---|---|
| Direct Connection | 否,直連資料庫本體 | 通常 5432 | migration、pg_dump 備份、有 IPv6 的長駐後端 |
| Session Pooler | 是,session 模式 | 通常 5432(pooler 主機) | IPv4 環境的長駐後端、需要 prepared statements |
| Transaction Pooler | 是,transaction 模式 | 通常 6543(pooler 主機) | Serverless、Edge、高並發 |
這裡有一個很多人踩過的坑:IPv4 / IPv6。Direct Connection 的主機在許多方案下只提供 IPv6 位址,如果你的執行環境(某些雲端函式平台、老舊網路)不支援 IPv6,直連就會失敗。這時候即使你只是要一條長駐連線,也得改走 Session Pooler——因為 pooler 主機同時提供 IPv4,等於幫你繞過 IPv6 的限制。所以「選 Session Pooler」有時不是為了池化的省連線效果,純粹是為了 IPv4 相容性。
一句話收束核心概念:跑 migration/備份用 Direct;長駐後端有 IPv6 用 Direct、只有 IPv4 用 Session Pooler;Serverless/Edge 一律用 Transaction Pooler。 記住這條,大部分連線抉擇都不會錯。
實作範例
以下所有連線字串都以佔位符呈現(主機、專案參照、密碼請換成你自己的)。取得真實字串的正確方式:到 Supabase Dashboard 右上角點 Connect,裡面會直接給你 Direct、Session Pooler、Transaction Pooler 三組完整字串與正確的埠——一律以那裡顯示的為準,不要硬記埠號。
三種連線字串長什麼樣
連線字串的通用格式是 postgresql://[使用者]:[密碼]@[主機]:[埠]/[資料庫]。三種連線方式的差別就在主機、埠、以及使用者名稱格式:
# 1) Direct Connection —— 直連資料庫本體,埠通常 5432
#    主機是 db.[project-ref].supabase.co;使用者就是 postgres
postgresql://postgres:[YOUR-PASSWORD]@db.[PROJECT-REF].supabase.co:5432/postgres

# 2) Session Pooler —— 走 pooler 主機,埠通常 5432
#    使用者要帶專案參照:postgres.[project-ref]
postgresql://postgres.[PROJECT-REF]:[YOUR-PASSWORD]@aws-0-[REGION].pooler.supabase.com:5432/postgres

# 3) Transaction Pooler —— 走 pooler 主機,埠通常 6543(Serverless 用這個)
postgresql://postgres.[PROJECT-REF]:[YOUR-PASSWORD]@aws-0-[REGION].pooler.supabase.com:6543/postgres

# 建議一律加上 SSL 確保連線加密
postgresql://postgres:[YOUR-PASSWORD]@db.[PROJECT-REF].supabase.co:5432/postgres?sslmode=require
注意 pooler 的兩組(Session/Transaction)使用者名稱都是 postgres.[PROJECT-REF] 的格式,且主機相同、只差在埠。埠號會依你的方案與區域而定,請以 Dashboard 的 Connect 頁面為準(以官方為準)。
用 Direct Connection 跑 migration 與備份
需要「完整連線能力」的操作——遷移、備份、大量匯入——用 Direct Connection 最合適,因為這些操作往往需要 prepared statements、暫存或 session 狀態,不適合走 transaction pooler:
# psql 直連
psql "postgresql://postgres:[YOUR-PASSWORD]@db.[PROJECT-REF].supabase.co:5432/postgres"

# pg_dump 備份(自訂格式,方便還原)
pg_dump "postgresql://postgres:[YOUR-PASSWORD]@db.[PROJECT-REF].supabase.co:5432/postgres" \
  -Fc -f backup.dump
在 Serverless 用 Transaction Pooler(Node.js 範例)
Serverless 的正確做法有兩個重點:一、走 Transaction Pooler 的連線字串;二、在模組層級(而非每次請求)建立連線池,讓實例存活期間重用連線。 以 node-postgres(pg)為例:
// db.js —— 在模組層級建立 Pool,實例存活期間重用,而非每次請求都新建
import { Pool } from 'pg'

const pool = new Pool({
  // 這裡放 Transaction Pooler 的連線字串(埠 6543)
  connectionString: process.env.DATABASE_URL,
  max: 5, // Serverless 環境刻意用「小」pool,避免眾多實例合計爆掉連線
})

export default pool
// handler.js —— 每次請求向 pool 借一條、用完歸還
import pool from './db.js'

export async function handler(req) {
  const client = await pool.connect()
  try {
    const { rows } = await client.query('select id, title from posts limit 20')
    return rows
  } finally {
    client.release() // 一定要歸還,否則連線會洩漏
  }
}
反面教材是「每次請求都 new Client() 再 connect()」——那等於每個請求各開一條新連線,Serverless 一放大就把上限打爆。務必在模組層級建立 Pool。
用 Prisma 走 Transaction Pooler:停用 prepared statements
Prisma 預設會用 prepared statements,走 Transaction Pooler 時必須在連線字串加上 pgbouncer=true 來停用它,否則會報錯:
# .env
# Transaction Pooler(埠 6543)+ pgbouncer=true 停用 prepared statements
DATABASE_URL="postgresql://postgres.[PROJECT-REF]:[YOUR-PASSWORD]@aws-0-[REGION].pooler.supabase.com:6543/postgres?pgbouncer=true&connection_limit=1"

# migration 另外走 Direct Connection(Prisma 用 directUrl 指定)
DIRECT_URL="postgresql://postgres:[YOUR-PASSWORD]@db.[PROJECT-REF].supabase.co:5432/postgres"
// schema.prisma
datasource db {
  provider  = "postgresql"
  url       = env("DATABASE_URL") // 應用查詢走 Transaction Pooler
  directUrl = env("DIRECT_URL")   // prisma migrate 走 Direct Connection
}
這個「查詢走 pooler、migration 走 direct」的雙字串配置,是 Prisma + Supabase 的標準做法,記起來能省下大量除錯時間。
查看目前連線數
想知道自己離連線上限還有多遠,可以在 SQL Editor 查 pg_stat_activity:
-- 目前總連線數
select count(*) from pg_stat_activity;

-- 依連線狀態分類(idle 太多通常代表連線沒被好好回收)
select state, count(*)
from pg_stat_activity
group by state
order by count(*) desc;
idle 連線過多,往往是「借了不還」或 pool 開太大的徵兆,正是連線耗盡的前兆。
常見錯誤與最佳實踐
坑一:Serverless 用 Direct Connection,流量一大就爆連線。
這是最常見、也最痛的坑。Serverless 每個實例各開一條 Direct 連線,尖峰時數百個實例同時湧入,瞬間打爆 Postgres 的連線上限,網站回報 too many clients。正確做法:Serverless/Edge/Next.js API Routes 一律走 Transaction Pooler(埠通常 6543),並在模組層級建立小 pool(max 設小一點),讓少數實體連線被高效重用。
坑二:Transaction Mode 用 prepared statements,報莫名其妙的錯。
在 Transaction Mode 下,連線是「一個交易借一條、結束就還」,下一個交易可能被分到別條實體連線,先前 PREPARE 的語句在那條連線上不存在,於是報錯。正確做法:走 Transaction Pooler 就要停用 prepared statements——Prisma 在連線字串加 pgbouncer=true;node-postgres 等驅動則停用其 prepared statement 快取。需要 prepared statements 或長連線狀態時,改走 Session Mode 或 Direct Connection。
坑三:埠用錯——把 6543 當 5432 或反過來。 Transaction 與 Session Pooler 主機相同、只差在埠,很容易貼錯。埠貼錯會讓你「以為在用 transaction pooler,其實走的是 session」,池化行為與 prepared statements 支援全變樣,症狀非常難查。正確做法:不要憑記憶填埠,直接複製 Dashboard Connect 對話框裡對應那一組的完整字串(以官方為準),確保埠、主機、使用者名稱一次到位。
坑四:IPv6 直連在不支援 IPv6 的環境失敗。 Direct Connection 主機在許多方案下只給 IPv6,若執行環境不支援 IPv6,直連就是連不上。正確做法:長駐後端但環境只有 IPv4 時,改走 Session Pooler(pooler 主機提供 IPv4),或依方案購買 IPv4 add-on 讓 Direct 可用。
坑五:pool 開太大或「借了不還」。
把連線池 max 設得很大,或忘了 client.release()/沒關閉連線,會讓 idle 連線堆積,一樣會撞上上限。正確做法:Serverless 環境刻意把 pool 設小;每次借出連線一定在 finally 裡 release();用 pg_stat_activity 定期檢查 idle 連線是否異常堆積。
最佳實踐總結:
- Serverless/Edge → Transaction Pooler(埠通常 6543),並在模組層級建小 pool、重用連線
- 長駐後端 → 有 IPv6 用 Direct、只有 IPv4 用 Session Pooler
- migration/
pg_dump備份 → Direct Connection(需完整連線能力) - 走 Transaction Pooler 一律停用 prepared statements(Prisma 加
pgbouncer=true) - 埠與連線字串一律以 Dashboard 的 Connect 頁面為準,不要硬記
- 每次借出連線務必歸還,並用
pg_stat_activity監控idle連線
小結
這篇是 Supabase 系列教學的第 008 篇,也是整個「資料庫段」的收尾。承接上一篇《Database Functions 與 Triggers》——我們讓資料庫在資料變更瞬間自動運轉,這篇則解決「應用長大後連線成為瓶頸」的問題:
- 為何需要連線池:Postgres 連線很貴、有上限,Serverless 每個實例各開連線特別容易耗盡
- Supavisor 是什麼:Supabase 自研的連線池器,在多客戶端間智慧分配少數實體連線
- 兩種模式:
session mode(綁整個連線期、支援 prepared statements)vstransaction mode(一交易借一條、重用率最高、不支援 prepared statements) - 三種連線:Direct(migration/備份/IPv6 後端)、Session Pooler(IPv4 長駐後端)、Transaction Pooler(Serverless/Edge)
- 常見坑:Serverless 用 Direct 爆連線、Transaction Mode 用 prepared statements 出錯、埠貼錯、IPv6 相容性、連線借了不還
至此,我們把 Supabase 底層的 Postgres 完整走了一遍:從資料表設計、關聯與索引、Extensions、Functions 與 Triggers,到這篇的連線管理。你已經掌握「資料怎麼存、怎麼算、怎麼連」。
但還有一塊最關鍵的拼圖沒補上:安全。前面我們多次提到 RLS(Row Level Security,行級安全性)——它是 Supabase 讓你「安全地把資料庫直接開放給前端查詢」的基石,也是 security definer 之所以危險、觸發器之所以能自動建 profile 的背後那道牆。下一篇《Row Level Security 入門》,我們正式進入 Supabase 的安全模型:什麼是 RLS、enable row level security 之後為什麼「全部資料都不見了」、using 與 with check 的差別,以及如何寫出第一條讓「使用者只看得到自己資料」的政策。資料庫段到此收尾,安全段正式開始。下一篇見。